Wie es gemacht wurde
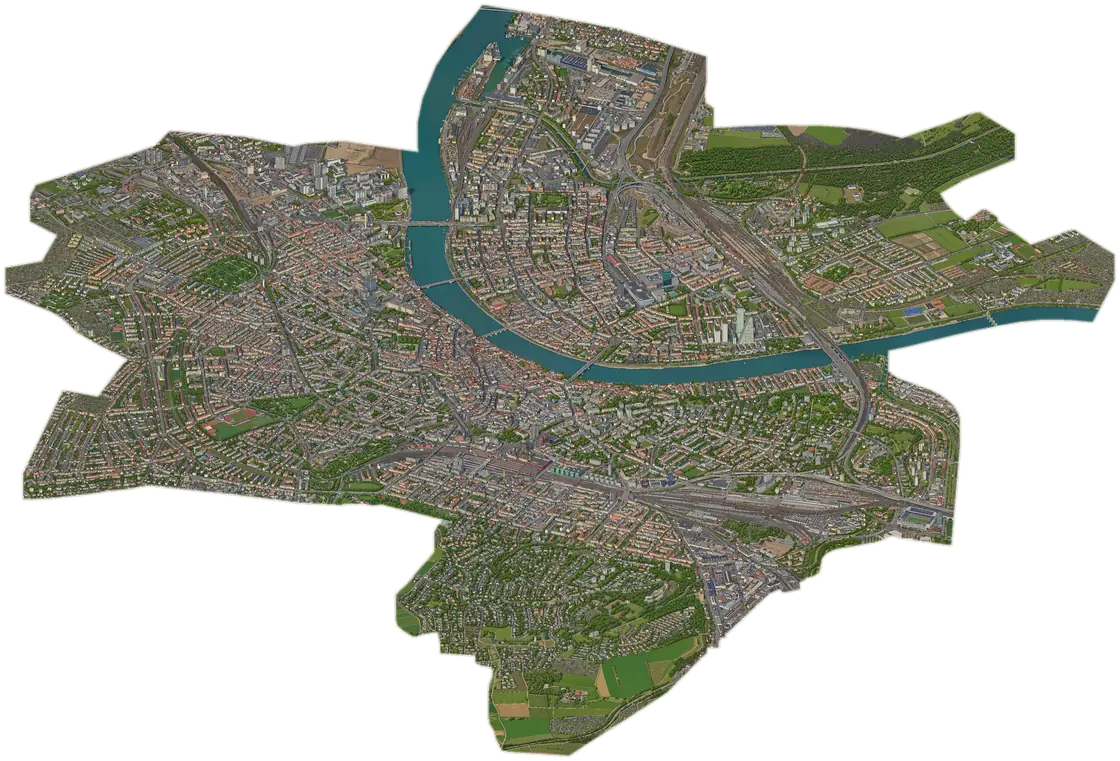
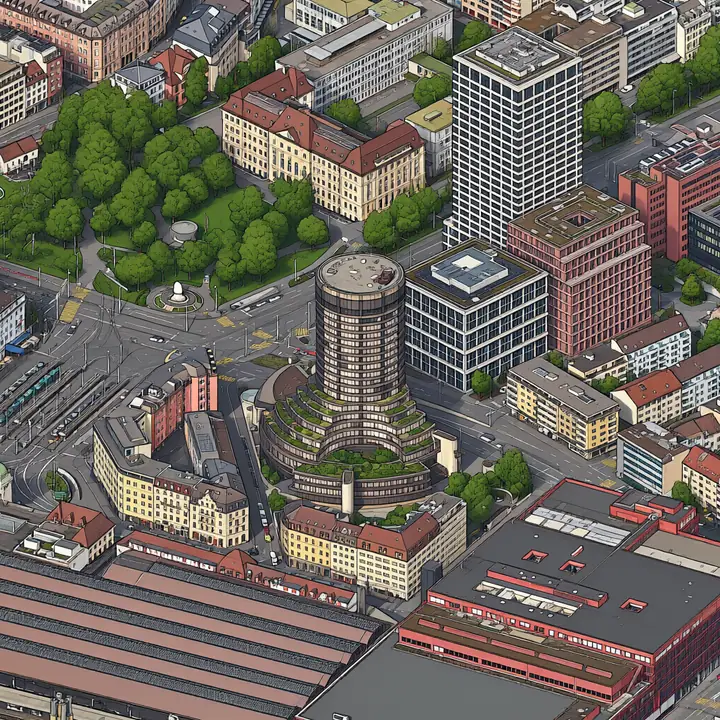
Die Karte zeigt die ganze Stadt Basel als Zeichnung, aus vier Blickrichtungen. Kein Mensch hat sie von Hand gezeichnet, und sie ist auch kein Foto: Ein kleines Bildmodell hat gelernt, das 3D-Luftbild des Kantons Strich für Strich nachzuzeichnen.
Die kurze Antwort
Die Methode stammt von Tiny London und Isometric Toronto; hier wurde sie auf Basel übertragen. In fünf Sätzen:
- Eine Kamera ohne Perspektive fotografiert das 3D-Modell der Stadt in überlappenden Kacheln.
- Ein grosses Bildmodell (der «Lehrer», GPT Image 2.6) zeichnet einige hundert dieser Kacheln nach.
- Automatische Prüfungen werfen jede Zeichnung weg, die nicht exakt auf ihrer Vorlage liegt oder etwas erfindet.
- Ein kleines Zusatzmodell (ein LoRA für Qwen-Image-2.1-Turbo) lernt aus den übrigen Paaren den Zeichenstil.
- Dieses Modell zeichnet die ganze Stadt, und zwar jede Blickrichtung als ein zusammenhängendes Bild, damit keine Nähte entstehen.
- 23,9 km²Stadt Basel, ohne Riehen und Bettingen
- 4Blickrichtungen, je eine eigene Zeichnung
- 2,6 Mrd.Pixel in allen vier Bildern
- 25 cmBoden pro Pixel
- 348Bildpaare zum Lernen
- 59.36 $bezahlte Rechnungen, alles zusammen
Vom ersten Probebild bis zur vierten Blickrichtung vergingen zwei Tage, der 13. und 14. November 2026.
Die Vorlage: das 3D-Luftbild der Stadt
Der Kanton Basel-Stadt veröffentlicht sein 3D-Luftbild 2026 als offene Geodaten: ein texturiertes 3D-Modell, das aus Luftaufnahmen berechnet wurde. Es lässt sich ohne Schlüssel und ohne Konto laden. Dafür gebührt dem Kanton Dank und die Zeile «Quelle: Geodaten Kanton Basel-Stadt».
Das Modell deckt Basel, Riehen und Bettingen ab. Die Karte zeigt nur die Stadt Basel; die Gemeindegrenze kommt von swisstopo, alles ausserhalb ist in Papierfarbe übermalt.
Eine Eigenheit: Geflogen wurde im Winter. Im 3D-Modell stehen die Bäume kahl. Auf der Karte tragen sie Sommerlaub, das ist die einzige Stelle, an der die Zeichnung bewusst von der Vorlage abweicht (mehr dazu beim Lehrer).
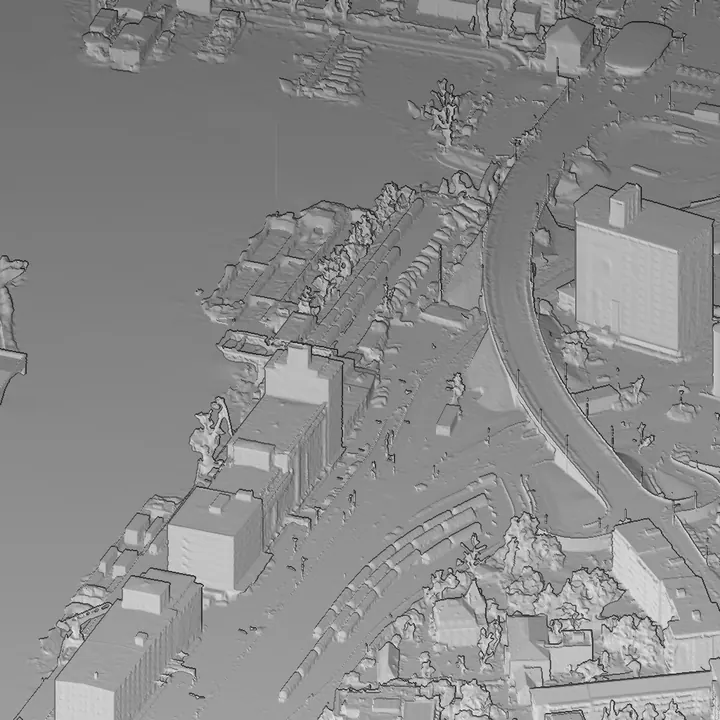
Was online ist und was nicht: Veröffentlicht wird nur die Zeichnung. Die Bilder des 3D-Modells selbst sind nirgends auf dieser Seite zu sehen. Als «Vorher» stehen darum unten graue Reliefbilder: Sie zeigen nur die Form, die das Modell an dieser Stelle hat, ohne Luftbild darauf.
Die Kamera
Alles hängt daran, dass Vorlage und Zeichnung Pixel für Pixel übereinanderliegen. Darum gibt es genau eine Kamera: ohne Perspektive (parallele Sehstrahlen), 30° über dem Horizont, 25 cm pro Pixel. Sie wird nur um ganze Pixel verschoben.
- Ein Bild ist 1024 × 1024 Pixel gross, das nächste beginnt 768 Pixel weiter. Nachbarn überlappen sich also um ein Viertel.
- Pro Blickrichtung sind es 640 bis 672 Bilder, zusammen 2656. Zu jedem gehört ein Tiefenbild: die Entfernung jedes Pixels von der Kamera in Metern.
- Gerendert wird in einem Browser ohne Fenster auf dem Laptop. Allein für den Blick nach Norden wurden 68 653 Kacheln des 3D-Modells geladen.
- Ein Bild wird erst gespeichert, wenn nichts mehr lädt und sich das Bild über mehrere Durchläufe nicht mehr ändert.
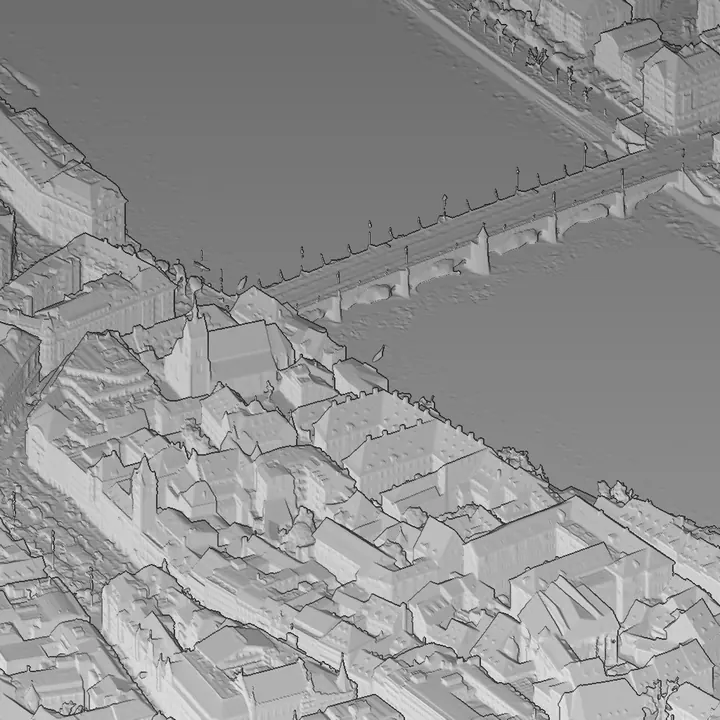 Form (Tiefenbild)
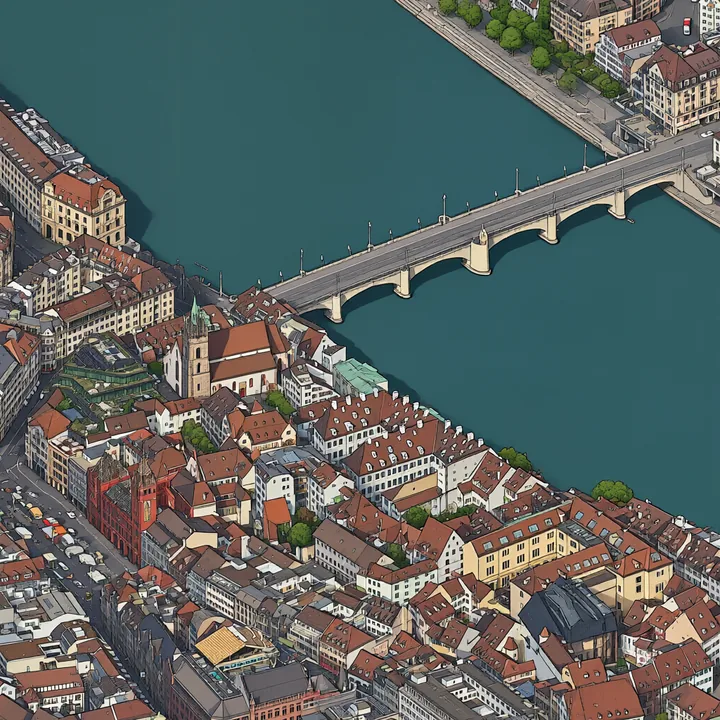 Zeichnung
Der Lehrer
Ein kleines Modell lernt einen Stil nur, wenn ihm jemand Beispiele zeichnet. Diese Beispiele kommen von einem grossen Bildmodell. Vier Kandidaten zeichneten zuerst dasselbe Probebild (GPT Image 2.6 und 2.5, Gemini Nano Banana 2.1, Gemini 3 Pro Image); gewählt wurde GPT Image 2.6.
Die Anweisung an den Lehrer beschreibt nur die Zeichentechnik und nennt keine Dinge, die im Bild vorkommen könnten. Sonst zeichnet das Modell gern etwas dazu. Im Kern steht:
- Treue zuerst: nichts hinzufügen, nichts weglassen, jede Form am selben Pixel.
- Flache Farbflächen mit dünnen dunklen Umrissen, zwei bis drei Töne pro Fläche, in der Art eines Aufbauspiels der 1990er-Jahre.
- Jede Fläche behält ihren Farbton. Keine lesbare Schrift, keine Logos.
- Die eine erlaubte Änderung: Wo kahle Äste zu sehen sind, steht derselbe Baum im Sommerlaub, nicht breiter als seine Äste.
Für das Lernset wurden 420 Bilder ausgesucht, ausgewogen über sechs Arten von Stadt: Altstadt und dichte Blöcke, niedrige Wohnquartiere, Wasser, Bahn und Industrie, Parks und Wald, grosse moderne Bauten. Der Lehrer wurde dafür 604-mal aufgerufen; das dauerte 84 Minuten und kostete 32.85 $.
Die Prüfungen
Ein Bildmodell hält sich nicht immer an die Anweisung. Darum wird jede Zeichnung des Lehrers automatisch gegen Daten geprüft, denen man trauen kann: das Bild selbst, sein Tiefenbild, die amtliche Vermessung des Kantons (Gebäude, Wasser, Grünflächen, Bahnareal) und das Höhenmodell von swisstopo.
| Prüfung | Was sie verlangt | Ablehnungen |
|---|---|---|
| Lage | Höchstens 1 Pixel verschoben, höchstens 0,2 % gezoomt, höchstens 0,15° gedreht | 4 |
| Struktur | Mindestens 87 % der Kanten aus dem Tiefenbild sind gezeichnet; kaum Umrisse ohne Vorlage | 42 |
| Wasser | Rhein, Wiese und Hafenbecken bleiben Wasser; Land wird nicht zu Wasser | 39 |
| Farbe | Jeder kleine Block und jedes Gebäude behält seinen Farbton | 121 |
| Bäume | Mindestens die Hälfte der Baumfläche ist grün; kein Neongrün; kein Grün, wo nichts wächst | 131 |
| Schrift | Keine lesbaren Buchstaben oder Zahlen (Texterkennung) | 11 |
Ablehnungen: wie oft die Prüfung unter den 226 abgelehnten Zeichnungen als Grund genannt wurde. Eine Zeichnung kann mehrere Gründe haben.
Von 593 geprüften Zeichnungen wurden 367 angenommen (62 %). 309 Bilder gelangen beim ersten Versuch, 40 beim zweiten, 18 beim dritten. 53 Bilder wurden nach drei Ablehnungen aufgegeben. Von den 367 Paaren dienen 348 zum Lernen; 19 bleiben zurück, um später die Zwischenstände des Modells zu vergleichen.
Ein Selbsttest beschädigt gute Zeichnungen absichtlich (verschoben, gezoomt, ein Block gelöscht, ein Block erfunden, Wasser grau, Dächer orange) und schaut, ob die richtige Prüfung anschlägt.
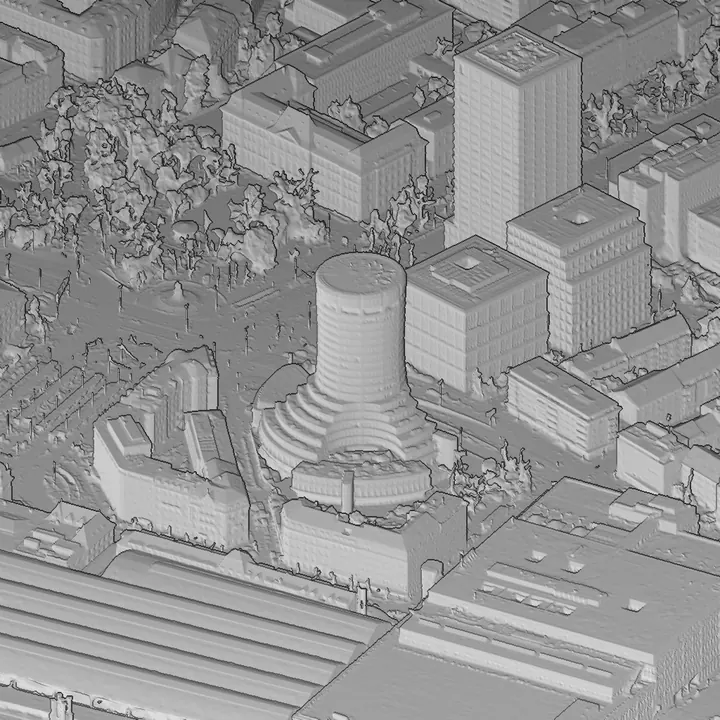 Form (Tiefenbild)
 Zeichnung
Das kleine Modell
Der Lehrer ist zu teuer und zu eigenwillig für die ganze Stadt. Gezeichnet wird sie von Qwen-Image-2.1-Turbo, einem offenen Bildmodell, das ein Bild in nur 8 Schritten bearbeitet. Ein LoRA, eine kleine Zusatzdatei von 159 MB, bringt ihm den Stil bei.
- Training mit ai-toolkit auf einer gemieteten Grafikkarte (H100, 80 GB).
- Rang 32, Lernrate 0,0001, ein Bildpaar pro Schritt, Bilder in 1024 Pixeln, 3000 Schritte.
- Alle 500 Schritte wird ein Zwischenstand gespeichert, etwa alle 21 Minuten. Das ganze Training dauerte gut zwei Stunden.
- Ein Trainingsadapter sorgt dafür, dass das Modell seine 8 Schritte behält: Er ist beim Lernen eingeschaltet und beim Zeichnen aus.
Welcher Zwischenstand der beste ist, entscheiden die 19 zurückbehaltenen Bilder:
| Stand | Versatz | Kanten | Farbabstand |
|---|---|---|---|
| Ohne LoRA | 2,8 px | 73 % | 44,1 |
| 500 Schritte | 0,7 px | 83 % | 27,3 |
| 1500 Schritte | 0,7 px | 83 % | 25,5 |
| 2500 Schritte | 0,7 px | 84 % | 25,1 |
| 3000 Schritte (gewählt) | 0,7 px | 84 % | 24,5 |
Versatz: grösste Verschiebung gegenüber der Vorlage. Kanten: Anteil der kräftigen Kanten des Lehrers, die das Modell auch zeichnet. Farbabstand: mittlerer Abstand zur Zeichnung des Lehrers, kleiner ist näher.
Hier war der letzte Stand knapp der beste. Das ist nicht selbstverständlich; in Toronto lag der beste Stand zweimal vor dem Ende.
Die ganze Stadt als ein Bild
Zeichnet man 640 Kacheln einzeln und klebt sie zusammen, sieht man jede Klebestelle: Jede Kachel ist ein wenig anders hell, ein Dach wechselt mitten im First die Farbe. Mehr Training hilft dagegen nicht. Die Lösung liegt im Zeichnen selbst.
Das Modell arbeitet nicht direkt an Pixeln, sondern an einem verkleinerten Zwischenbild, das in 8 Schritten vom Rauschen zur Zeichnung wird. Für jede Blickrichtung gibt es ein einziges solches Zwischenbild für die ganze Stadt:
- Bei jedem Schritt schaut das Modell durch Fenster von 1024 Pixeln, die 768 Pixel auseinander liegen. Wo sich Fenster überlappen, werden ihre Vorschläge gemischt.
- Bei jedem zweiten Schritt ist das Fensterraster um 384 Pixel verschoben. So liegt keine Fenstergrenze zweimal am selben Ort.
- Die Stadt ist in Blöcke von 3072 Pixeln geteilt, 40 bis 42 pro Blickrichtung. Ein Block sieht 768 Pixel seiner fertigen Nachbarn als festen Rand und zeichnet einen Streifen von 256 Pixeln davon neu, um weich anzuschliessen.
- Die Blöcke laufen in vier Wellen. Ein Block darf erst beginnen, wenn alle Nachbarn fertig sind, an die er anschliesst.
- Eine Maschine weigert sich zu zeichnen, wenn eine Vorlage fehlt oder ihre Prüfsumme nicht stimmt. In allen vier Durchgängen wurde kein Block verweigert.
- 166Blöcke in vier Blickrichtungen
- 32 672Fenster-Auswertungen
- 0,42 spro Fenster auf einer H100
- knapp 1 hpro Blickrichtung
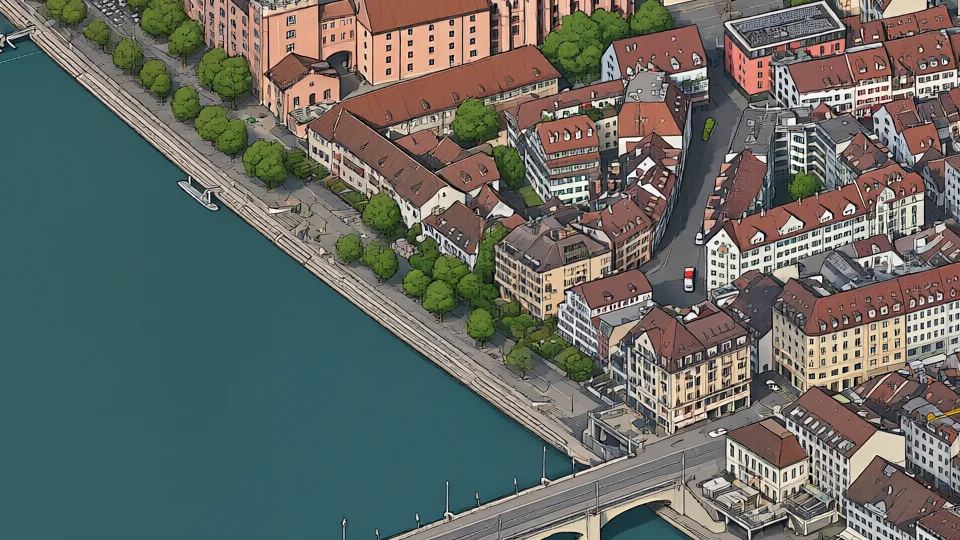
Nachgemessen wurde zweierlei. Der Blick nach Norden liegt im Mittel 0,3 Pixel neben der Vorlage, verschoben werden musste nichts. Und gemeinsam gezeichnete Blöcke kommen etwas dunkler heraus als einzeln gezeichnete Bilder, um etwa 4 von 100 Helligkeitsstufen. Dasselbe wurde in Toronto beobachtet.
Vier Blickrichtungen
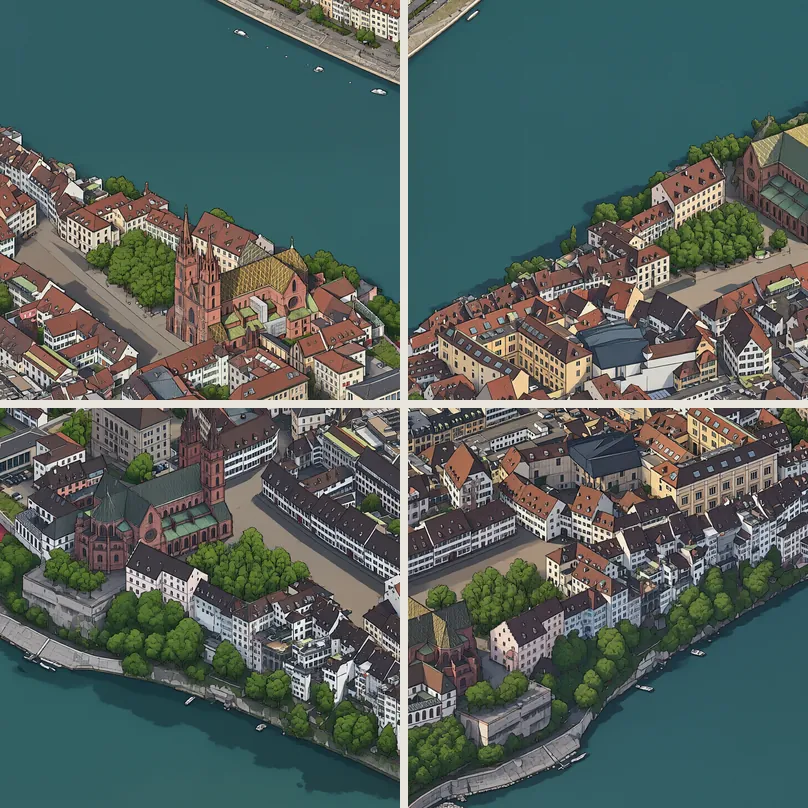
«Drehen» zeigt keine gespiegelte Kopie. Jede Blickrichtung ist neu aus dem 3D-Modell gerendert und neu gezeichnet: Man sieht die Rückseite der Häuser, die vorher verdeckt war. Das Lernset enthielt von Anfang an Bilder aus allen vier Richtungen, deshalb reichte ein einziges LoRA.
Kacheln und Hosting
- Jede Blickrichtung wird in Kacheln von 512 Pixeln zerschnitten (WebP), in 7 bis 8 Zoomstufen.
- Zusammen sind es 13 642 Kacheln und 473 MB.
- Die Seite liegt als reine Sammlung statischer Dateien bei Cloudflare, im Gratis-Tarif. Es läuft kein Server-Code.
- Der Betrachter ist eine kleine Seite ohne Bibliotheken: ein Canvas, das die passenden Kacheln lädt. Über die Auflösung der Zeichnung hinaus bleiben die Pixel hart, statt zu verschwimmen.
 Form (Tiefenbild)
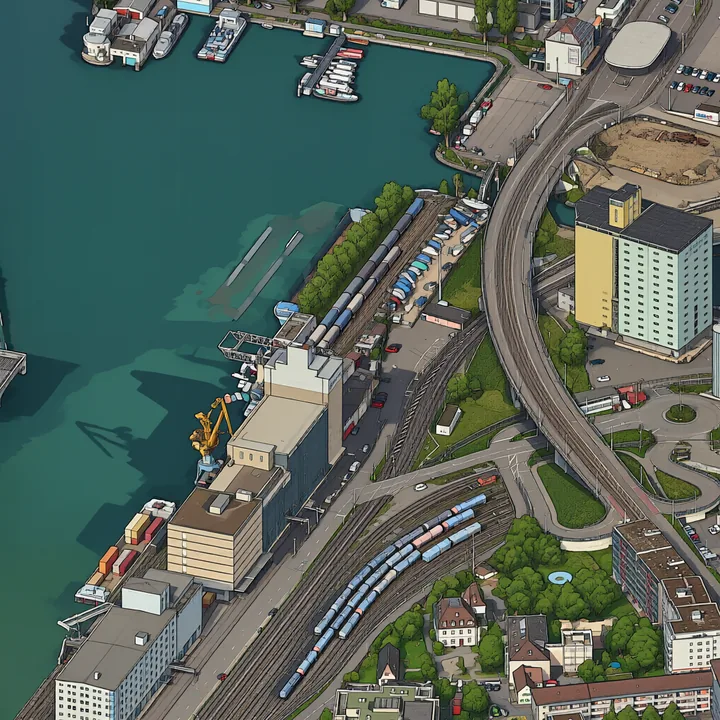 Zeichnung
Was schiefging
Ein Zwischenspeicher machte die Bilder unzuverlässig
Der 3D-Betrachter hält geladene Kacheln in einem Speicher von 0,4 GB. Auf dichten Bildern war der voll, und weitere Kacheln wurden stillschweigend abgewiesen. Dasselbe Bild sah dann je nach Vorgeschichte anders aus, ohne Fehlermeldung. Seither ist der Speicher grösser, wird nach jedem Block geleert, und ein Bild gilt erst als fertig, wenn es sich nicht mehr ändert.
Die Prüfungen waren zweimal zu streng
In der ersten Runde bestanden nur 6 von 23 Zeichnungen, obwohl viele von Auge gut waren. Die Schwellen wurden nachgestellt und alle Zeichnungen neu beurteilt. Später, nach dem grossen Durchgang, geschah dasselbe im Kleinen noch einmal: Die zweite Neubeurteilung hob die Zahl der angenommenen Paare von 352 auf 367. Eine Prüfung, die Gutes wegwirft, kostet Geld; eine, die Schlechtes durchlässt, verdirbt das Modell. Man muss beide Fehler anschauen.
Die Bäume sind die schwierigste Stelle
Kahle Bäume belauben und sonst nichts ändern: Das ist die Anweisung, an der der Lehrer am häufigsten scheiterte (131 Ablehnungen). Bäume zu erkennen ist auch für die Prüfung schwer; sie nimmt dafür das Tiefenbild zu Hilfe, in dem ein kahler Baum als dichtes Gewirr von Sprüngen erscheint.
Eine Grafikkarte löschte sich mitten im Hochladen
Jede gemietete Maschine bekommt eine Uhr mit, die sie nach einigen Stunden selbst löscht, damit keine vergessene Maschine das Guthaben aufbraucht. Die Uhr der zweiten Maschine lief ab, während gerade die Vorlagen für den Blick nach Süden hochgeladen wurden. Verloren ging nichts, weil jeder fertige Block sofort nach Hause kopiert wird. Für Süden und Westen wurde eine dritte Maschine gemietet.
Kleinere Dinge
- Der Lehrer antwortete einmal mit «vorübergehend nicht erreichbar», und eine Prüfung wurde einmal vom Betriebssystem abgebrochen. Beides fängt ein neuer Versuch auf.
- 53 der 420 ausgesuchten Bilder liessen sich in drei Versuchen nicht sauber zeichnen. Das Lernset hat darum 348 statt 400 Paare.
Was man mitnehmen kann
- Die Kamera zuerst. Wenn Vorlage und Zeichnung nicht auf den Pixel stimmen, lernt das Modell Verschiebung statt Stil.
- Den Lehrer an wenigen Bildern auswählen, bevor man Hunderte bezahlt.
- Nichts ungeprüft ins Lernset lassen, und die Prüfungen selbst prüfen.
- Zwischenstände vergleichen und nicht einfach den letzten nehmen.
- Einheitlichkeit über die ganze Karte ist eine Frage des Zeichnens, nicht des Trainings.
- Jeder bezahlte Aufruf läuft durch eine eigene Obergrenze und wird aufgeschrieben. Beim Anbieter liegt nur vorausbezahltes Guthaben.
Was es gekostet hat
| Posten | Was es war | US-Dollar |
|---|---|---|
| Lehrer: GPT Image 2.6 | 639 Aufrufe: Stilproben, Prüfrunden und das Lernset (davon 32.85 $ für das Lernset) | 35.06 |
| Lehrer: Vergleich | Je ein Probebild von drei anderen Modellen | 0.40 |
| Grafikkarte, Probelauf | Einrichten, 40 Trainingsschritte, Selbsttest, zwei Blöcke | 2.24 |
| Grafikkarte, Hauptlauf | 3000 Schritte Training, Vergleich der Zwischenstände, Norden und Osten | 14.50 |
| Grafikkarte, dritter Lauf | Süden und Westen | 7.16 |
| Rendern, Prüfen, Kacheln | Auf dem eigenen Laptop | 0.00 |
| Hosting | Cloudflare, Gratis-Tarif | 0.00 |
| Total | 59.36 |
Stand 14. November 2026, aus dem Kostenbuch des Projekts. Gemietet wurde jeweils eine H100 bei Vast.ai; die dritte kostete 2.34 $ pro Stunde. Nicht eingerechnet ist die Arbeitszeit.
Dank
- Tiny London von Boris Starkov: Von dort stammt die Methode, eine ganze Stadt als ein Bild zu zeichnen. Der Bericht ist lesenswert.
- Isometric NYC von Andy Coenen: das erste Projekt dieser Art, auf dem Tiny London aufbaut.
- Isometric Toronto: der Bericht, dem diese Karte Schritt für Schritt gefolgt ist.
- Der Kanton Basel-Stadt für das offene 3D-Luftbild und die amtliche Vermessung, swisstopo für Grenze und Höhenmodell.
- OpenAI (GPT Image 2.6) als Lehrer, Qwen als Grundlage des Modells: Built with Qwen.
Alle Quellen mit ihren Lizenzen stehen unter Quellen und Lizenzen.